网易 LobsterAI 发布了第二期《中国办公 Agent 用户行为报告》,报告基于它自己平台的用户数据,反映的是这一家产品的用户,不代表整个行业。
不过管中窥豹,可以借此看看中国办公 Agent 用户行为变化。也希望其他家多发一些类似报告学习下。
从这期起报告改为每月发布,9
IT技术
(
twitter.com
)
网易 LobsterAI 发布了第二期《中国办公 Agent 用户行为报告》,报告基于它自己平台的用户数据,反映的是这一家产品的用户,不代表整个行业。
不过管中窥豹,可以借此看看中国办公 Agent 用户行为变化。也希望其他家多发一些类似报告学习下。
从这期起报告改为每月发布,9 月版还额外看了十一假期的变化。
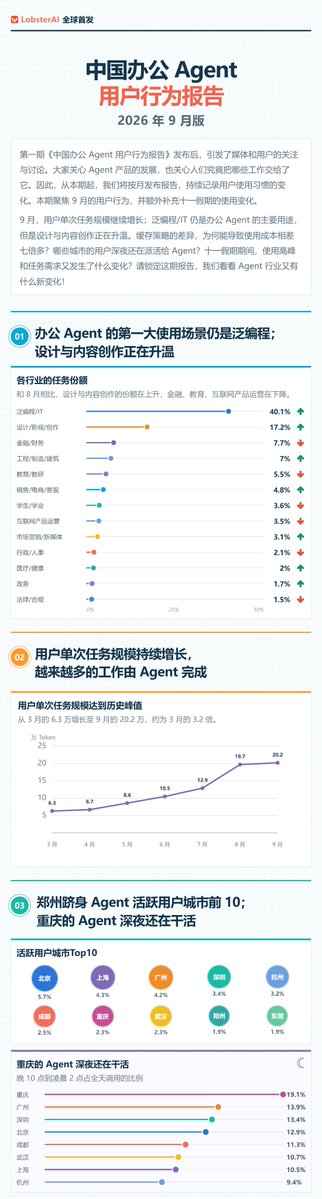
最醒目的数字有两个:9 月用户每次交给 Agent 的任务平均消耗 20.2 万 Token,是 3 月 6.3 万的 3.2 倍;日均活跃用户的增幅达到 83.1%,是 5 月以来涨得最快的一个月。用的人越来越多,每个人交出去的活也越来越大。
LobsterAI 是网易的办公 Agent 产品,可以在桌面端用,也可以在微信、飞书这类聊天软件里直接给它派活。
【任务越来越大,用户在加速涌入】
Token 是模型读写文字的计量单位。Agent 干活时要反复读任务要求、读自己前面产出的内容,所以一次任务消耗多少 Token,大致反映这件活有多长、多复杂。逐月看:3 月 6.3 万,4 月 6.7 万,5 月 8.6 万,6 月 10.5 万,7 月 12.9 万,8 月 19.7 万,9 月 20.2 万。最大的一跳在 7 月到 8 月,9 月停在高位。
日活这边,报告只给了增幅:6 月 +19.8%,7 月 +25.1%,8 月 +30.6%,9 月 +83.1%,一个月比一个月快。报告没公布用户绝对数。如果这些增幅是逐月环比,连乘下来 9 月日活大约是 5 月的 3.6 倍,这是按图上数字推算的,报告本身没这么说。
【缓存让同样的活,花费差出七倍多】
这是报告里对用户最实用的一节。Agent 每一步都要把任务要求和之前的内容重新读一遍,不少费用就花在这些重复读取上。模型厂商会把读过的内容记下来(缓存),再次读到时按折扣价收费。命中率就是重复内容里有多少能享受到这个折扣。
9 月各模型的命中率大多在九成上下:DeepSeek V4.1 Flash 最高,97.3%;DeepSeek V4 Flash 和 V4 Pro 都是 95.7%;GLM 5.3 93.9%,MiniMax M3 93.7%,Qwen 3.8 Max 93.2%,GLM 5.3 Flash 91.1%,Kimi K3 88.7%;垫底的是 Qwen 3.7 Plus,76.7%。
命中率差不多,实际花费却差很多。报告算了"实际费用是原价的多少":DeepSeek V4.1 Flash 4.6%,V4 Flash 6.2%,V4 Flash Vision 6.7%,V4 Pro 7.5%;Qwen 3.8 Max 18.5%,Qwen 3.8 Flash 18.8%;Kimi K3 20.2%;GLM 5.3 29.6%,GLM 5.3 Flash 35.1%。最省和最贵之间差了七倍多。
差距主要来自缓存价,也就是命中后按原价的几成收费:DeepSeek 只收 2%(V4 Pro 是 3.3%),Kimi K3 收 10%,Qwen 3.8 收 12.5%,GLM 5.3 收 25%,GLM 5.3 Flash 收 28.8%。按"命中部分 × 缓存价 + 未命中部分按原价"去算,结果和报告的数字对得上,比如 GLM 5.3 Flash:91.1% × 28.8% + 8.9% ≈ 35.1%。也就是说,对大量使用 Agent 的人,缓存打几折比命中率高一两个点更影响账单。
【用来干什么:编程仍占四成,设计创作在升温】
按行业分,泛编程/IT 占 40.1% 的任务份额,稳居第一;设计/影视/创作 17.2%,排第二,比 8 月有所上升。之后是金融/财务 7.7%、工程/制造/建筑 7%、教育/教研 5.5%、销售/电商/客服 4.8%。和 8 月比,金融、教育、互联网产品运营(3.5%)的份额在下降。
【城市:郑州进前十,重庆深夜最忙】
活跃用户占比前五是北京 5.7%、上海 4.3%、广州 4.2%、深圳 3.4%、杭州 3.2%,之后是成都 2.5%、重庆和武汉各 2.3%,郑州和东莞各 1.9%,郑州是这期新挤进前十的城市。
另一组数据看的是晚 10 点到凌晨 2 点的调用占全天比例。重庆高达 19.1%,明显高于广州 13.9%、深圳 13.4%、北京 12.9%;上海只有 10.5%,杭州 9.4%。
【微信是第一派活入口,通勤路上就开始安排工作】
在聊天软件里派活的用户中,77% 用微信,飞书 14.3%,QQ 6.5%,企业微信 5%,其他 5%(一个人可以用多个,合计超过 100%)。
时间上,早上 9 点和 10 点通过聊天软件派活的份额分别是 6.3% 和 7.1%,同时段桌面端是 4.8% 和 6.4%。报告的解读是,不少人在早上通勤路上就已经用手机把活派出去了。到了下午,两条线基本重合。
【十一假期:白天出门玩,晚上回家让 Agent 干活】
假期里,凌晨 0 点到 7 点的调用份额从平时的 13% 升到 17%,全天高峰从平时的下午 4 点推迟到晚上 10 点。
任务结构也变了。和平时相比,泛编程/IT 的份额高了 4.0 个点,学习与教育、个人生活事务各高 1.6 个点,营销文案 +0.1;下降最多的是数据与表格(-2.9)和翻译润色(-1.6),金融与投资 -0.7,文档写作 -0.5。表格、翻译这类典型的上班活在假期明显退潮。
【选模型:近七成用户只用一个,DeepSeek 是标配底座】
普通用户里 73.6% 只用一个模型,人均 1.6 个;重度用户只用一个的降到 44.7%,用 4 个及以上的有 17.6%,人均 2.4 个。
最常见的模型搭配全部以 DeepSeek Flash 系列打底:搭 GLM 5.3 Flash 的占 14.0%,搭 DeepSeek V4 Pro 的占 12.4%,其余组合(搭 GLM 5.3 FlashX、Qwen 3.8 Max、Qwen 3.8 Flash、GLM 5.3)都只有 2% 左右或更低。
厂商层面,国内模型的 Token 份额环比变化是:智谱 GLM 约 +166.7%,DeepSeek 约 -0.3%,阿里 Qwen 约 -18.2%,MiniMax 约 -66.7%,月之暗面 Kimi 约 -78.6%。报告把智谱的增长归功于 GLM 新模型。
要注意这是份额的相对变化,报告没给各家的绝对份额,看不出智谱现在实际占多少。
图像和视频生成则是字节豆包 Seed 系列领先:图像生成里 Seedream 占 57.2%,MiniMax Image 36%,阿里通义万相 6.8%;视频生成里 Seedance 占 54.4%,MiniMax 海螺 28.1%,阿里 HappyHorse 17.5%。
点击图片查看原图

点击图片查看原图

点击图片查看原图

点击图片查看原图